


인공지능(AI) 분야는 종종 혼란스러운 영역처럼 보일 수 있지만, 실제로는 기업 자체뿐만 아니라 자체 순위를 정하기 위해 만들어진 단체들에 의해서도 놀라울 정도로 많은 분석, 성능 측정 및 테스트가 진행되고 있습니다.
이 그룹은 채팅봇이 수학 테스트를 완료하는 능력부터 모든 것을 테스트합니다.
이미지 만들기, 논리적인 설명을 제공하거나, 심지어 의학적 조언을 제공하거나, 단순히 그녀가 얼마나 감정적으로 지능적인지 보여줄 수도 있습니다.
이러한 다양한 테스트를 통해 모델들은 각기 다른 영역에서 강점과 약점을 드러냅니다. 예를 들어, GPT-5는 과학적 추론 능력은 뛰어나지만, 새로운 개념에 적응하는 능력에서는 제미니나 클로드 같은 모델에 비해 뒤처집니다.
이러한 각 테스트는 AI 모델에 대한 새로운 정보를 제공하며, 다양한 상황에서 어떤 도구가 가장 효과적인지 파악하는 데 중요합니다. 하지만 종종 간과되는 지표가 하나 있습니다. 바로 어떤 AI 모델이 최고의 사용자 경험을 제공하는가입니다.
인간 분류 체계
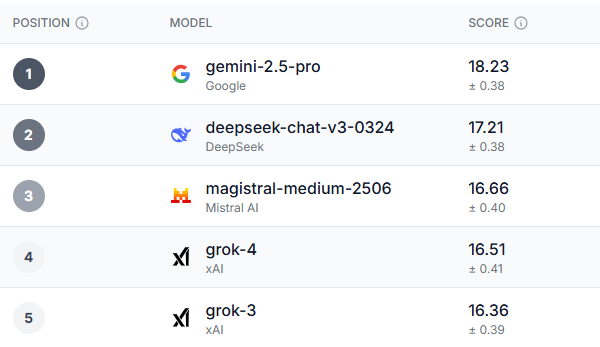
영국에 본사를 둔 기술 회사인 프로리픽(Prolific)은 휴메인(Humaine)이라는 AI 순위표를 만들었습니다 . 프로리픽은 AI의 작업 완료 능력을 테스트하는 대신, 이러한 모델을 통해 다양한 사용자 경험을 테스트했습니다.
도구를 사용한 21,352명의 경험을 평가함으로써 그들은 전반적인 승자를 찾을 수 있었을 뿐만 아니라 연령, 위치(테스트는 영국과 미국 모두에서 수행됨), 정치적 신념에 따라 결과를 분석할 수 있었습니다.
여기에는 다음에 대한 개별 목록이 포함됩니다.
- 영국: 연령대
- 영국: 인종
- 영국: 정치적 관점
- 미국: 연령대
- 미국: 인종
- 미국: 정치적 관점
연구팀은 각 참가자에게 두 개의 별도 AI 모델과 상호 작용하여 비교하도록 한 뒤, 각 상호 작용에서 어느 모델이 더 나은 성과를 거두었는지 피드백을 제공하도록 요청했습니다.
이를 통해 성과 부문에서 전체 우승자와 순위표가 만들어졌을 뿐만 아니라 기본 작업 성과와 추론 부문에서도 별도의 순위가 매겨졌고, 의사소통, 회복력, 신뢰, 윤리 부문에서도 우승자가 나왔습니다.
결과는 어떻게 나타났나요?
철저한 검토 끝에, 전반적인 성능 부문뿐만 아니라 대부분의 하위 부문에서도 확실한 승자가 나타났습니다. Gemini 2.5-Pro는 테스트에 포함된 거의 모든 벤치마크에서 탁월한 성능을 보였습니다.
영국의 18~34세 젊은 성인, 민주당 지지자, 그리고 미국의 55세 이상 유권자들은 제미니 2.5 프로를 전반적으로 가장 우수한 모델로 꼽았습니다. 모든 연령대에서 제미니보다 높은 점수를 준 유일한 영역은 신뢰, 윤리, 안전성이었는데, 이는 최근 안전성과 윤리적 문제에 직면했던 AI 모델인 그록-3에 대한 다소 아이러니한 결과입니다.
흥미롭게도 제미니 이후 등장한 세 가지 모델은 딥시크(Deepseek), 마지스트랄 르 샤(Magistral Le Chat), 그리고 그록(Grok) 입니다 . 딥시크는 올해 초 상당한 인기를 누렸지만 최근에는 주목도가 떨어졌습니다. 반면 르 샤는 인기는 덜하지만 충성도 높은 사용자층을 보유하고 있습니다.
그렇다면 세계적으로 유명한 ChatGPT는 이 모든 순위에서 어디에 위치할까요? ChatGPT는 최하위권에 머물러 있으며, 최고 버전인 GPT-4.1 모델로 8위를 기록했습니다. 더 심각한 것은 Claude 인데, 두 버전(4.0과 4.0) 모두 전체 순위에서 각각 11위와 12위를 차지했습니다.
그러면 이 모든 것이 무엇을 의미할까요?
그렇다면 Gemini가 세계 최고의 AI 챗봇이라는 뜻인가요? ChatGPT를 버려야 한다는 뜻인가요…? 글쎄요, 정확히는 그렇지 않습니다.
이러한 결과가 반드시 해당 모델의 성능을 반영하는 것은 아닙니다. 대부분의 다른 지표를 기준으로 테스트했을 때, 일반적으로 상위에 표시되는 옵션은 ChatGPT, Gemini, Claude, Grok입니다.
하지만 이는 이러한 테스트에 중요한 추가 사항입니다. 이 테스트는 인간 경험의 관점에서 AI를 더 잘 이해하는 데 도움이 됩니다. 예를 들어, 르샤(Le Chat)는 표준 벤치마크에서 높은 점수를 받지는 못했지만, 경험과 신뢰성 측면에서 훌륭한 선택으로 자주 언급됩니다.
이번 테스트에서 Anthropic과 OpenAI의 성과는 이 수준에는 미치지 못했지만, Gemini와 Grok은 또 다른 강력한 성과를 보였습니다. 두 회사 모두 벤치마크에서 높은 점수를 자주 기록했으며, 이번 테스트에서도 높은 점수를 유지했습니다.

댓글이 닫혔습니다.